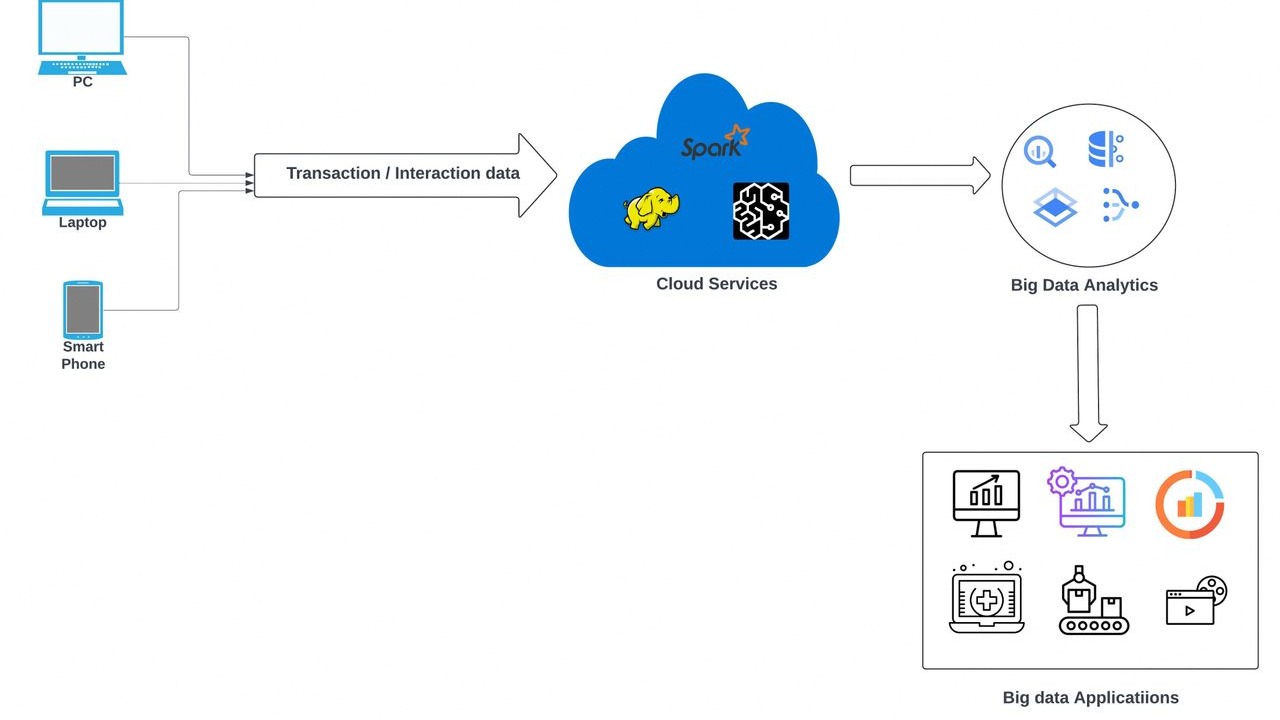
SnowflakeはCortex AIを通じてLLM呼び出しをネイティブなSQL関数にし、SQLに習熟した誰もが、データサイエンスチームや別個のAIパイプラインなしに分類、抽出、要約を実行できるようにした。戦略的な変化は微妙だが深い。AI採用の重心を、希少なML専門家から、SQLを読み書きできる膨大なビジネスアナリストのインストールベースへ移すものだからだ。
人材の計算は説得力がある。訓練されたデータサイエンティストは多くの大国でも数万人規模だが、SQL実務者はその一桁上の規模で存在する。AIをクエリの基本要素に変えることで、Snowflakeは'データアクセス'と'データインテリジェンス'の間の溝を埋める。まさに数え切れない企業AIパイロットが足踏みしてきた谷だ。規制産業にとっては、データをその場に置くアーキテクチャもコンプライアンス摩擦を和らげる。機微な記録が統治されたウェアハウスから出ないためだ。銀行のKYC文書トリアージや苦情ログ分類、保険の請求解析、製薬の試験データ分析で早期の牽引が見込まれる。
打撃が最も大きいのは、Accenture、NTT Data、Capgeminiなどのシステムインテグレーターやコンサルティング会社だ。彼らの収益は長く、専用データパイプラインを構築し、モデルをワークフローへつなぎ込むことに依存してきた。1行のSQLが数週間の統合プロジェクトを置き換えると、価値は実装からガバナンス、プロンプト設計、プロセス再設計へ移る。作って請求するサービスモデルはマージン圧縮に直面し、助言と監督が守れる高地になる。
反対側の重しはロックインだ。独自のCortex関数が織り込まれたクエリは、Databricks、Google BigQuery、Microsoft Fabricへ移植しにくく、3〜5年の視野でスイッチングコストを膨らませる。CIOは、SQLネイティブの便利さがポータビリティを手放す価値に見合うか判断しなければならない。正直な答えは条件付きだ。今日の便利さ、明日の囚われである。
推奨アクション: (1) ROIが最も高いユースケースを棚卸しし、Cortexをスタック全体に埋め込むのではなく狭くパイロットする。(2) 年次のデータポータビリティ監査を実施し、ビジネスロジックとベンダー固有関数の間に抽象化レイヤーを保つ。(3) インテグレーター依存を減らすため、アナリストの社内AIリテラシーを育てる。SQLとAIの収束は不可逆だ。出遅れた企業は、ロックインと人材の両方で二重に支払うことになる。




