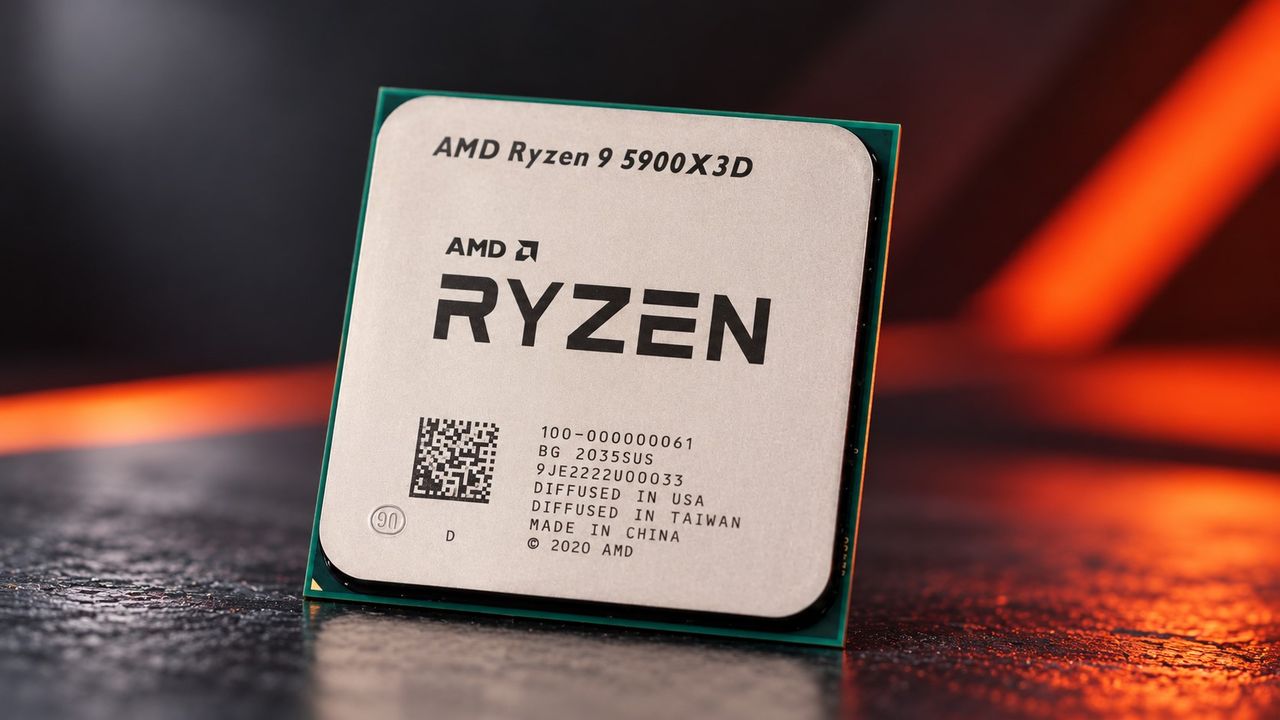
OpenAIは、自社のJalapeño推論用ASICのホストCPUとして、NvidiaのVeraではなくAMD EPYC Turinを採用したと報じられており、その理由として成熟度を挙げている。この詳細は表面的には些細に見えるが、AIコンピュート・スタック全体に形成されつつある断層線を浮き彫りにしている。
戦略的シグナルは、誰がホストを所有するかという点にある。カスタムアクセラレーターで満たされたラックにおいて、ホストCPUはもはや代替可能な付属品ではない。ワークロードのスケジューリング、データ移動を行い、ASIC周辺のソフトウェア契約を定義する。NvidiaのArmロードマップに緊密に結合された製品ではなく、オープンなx86パーツを選択することで、OpenAIは自社のアクセラレーターを単一ベンダーのラック・アーキテクチャから切り離した状態に保つ。これは、依然として依存しているGPUの唯一の供給元からのロックインに対するヘッジであり、AMDに信頼できる第二幕を与えることになる。GPUの挑戦者としてではなく、他社のシリコンすべてにとって中立的なホストとしての役割だ。ソケットを獲得したのは、生のパフォーマンスではなく成熟度だった。稼働時間と展開速度で測定されるワークロードにとって、実績のあるCPUとツールチェーンは、準備が整っていない高速チップを上回る。この計算式は、カスタムアクセラレーターと商用GPUを比較検討するすべてのハイパースケーラーで繰り返されるだろう。
二次的効果はマージンの移動である。最先端ラボが推論用シリコンを内製化するにつれ、かつてはすべてNvidiaに流れていた価値が、ASIC設計者、ファウンドリ、ホストCPUベンダーに分散する。Nvidiaの堀はトレーニング分野で保たれている。推論こそが、垂直統合の刃が交わる場所なのだ。
日本にとっての関連性は、モデル層ではなくサプライチェーンを通じて現れる。日本の材料、基板、パッケージング企業は、すべてのカスタムASICプログラムの上流に位置しており、特注アクセラレーターの増加は設計開始数の減少ではなく増加を意味する。これは、この変化を支えるテスト、組立、先進パッケージングの専門企業にとって追い風となる。ホストCPUの話は、日本のオペレーターとそのために構築するSIerにとってのデータセンター調達も再定義する。単一の統合ベンダースタックにラックを賭けることはロックインリスクを伴うが、分散型のx86プラスアクセラレーター・アプローチは、国内のAI構築がスケールする中で交渉力を保持する。
日本企業とそのSIパートナーにとって、実践的な教訓は、アクセラレーターの選択をスペックシート競争ではなく、ソフトウェアの移植性の問題として扱うことだ。推論ワークロードをいかなる単一シリコンベンダーからも抽象化する企業は、今日独自のラックに固定化する企業よりも、来るべき変動をはるかに安価に吸収できるだろう。