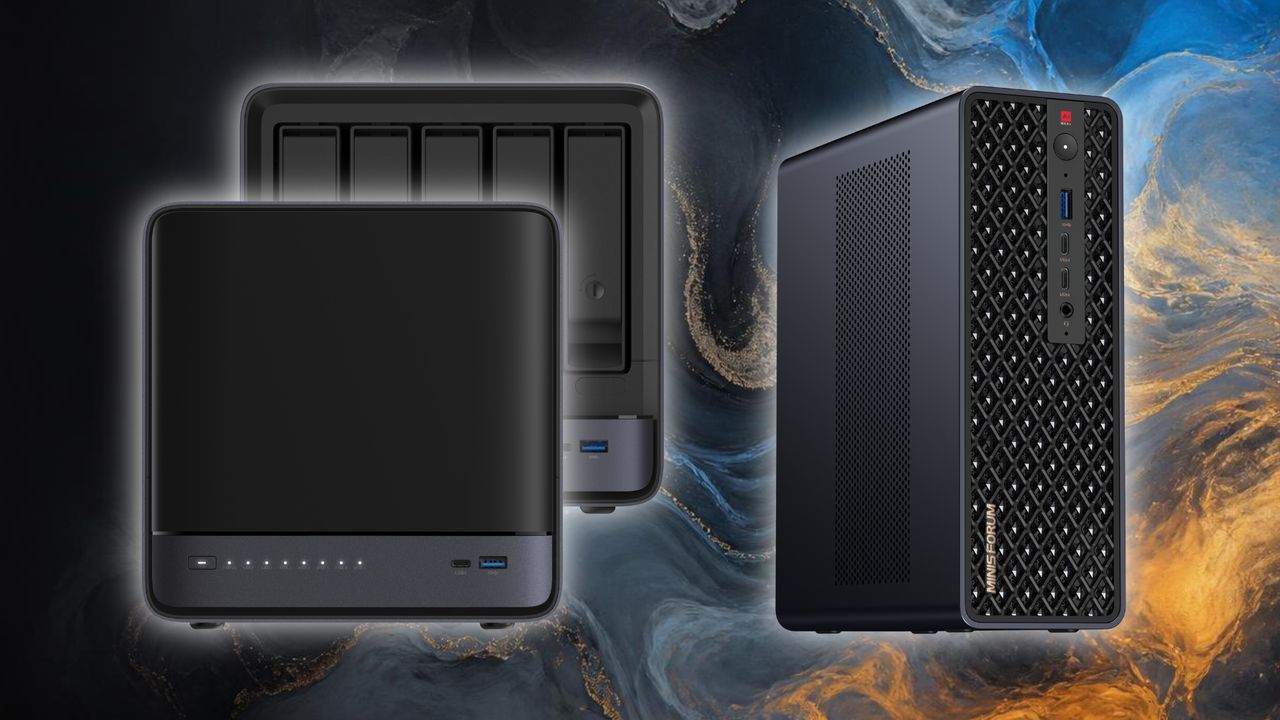
MinisforumがIFA 2026向けに発表したラインアップ——AMD製Ryzen AI Max+ Pro 495を搭載し、最大192GBのユニファイドメモリとRadeon 8065S統合GPUを備えたNASおよびミニワークステーション——は、単体製品としてよりも市場シグナルとして重要な意味を持つ。この容量のユニファイドメモリにより、デスクトップクラスのボックスが中規模モデルを高速な共有RAM上に完全に保持できるようになり、本格的なローカル推論を阻んできたディスクリートGPUのVRAM上限を回避できる。戦略的な読み方をすれば、プライベートAIの参入障壁が急速に下がっており、エッジにおけるトークン単価の引き下げを主導しているのはNvidiaではなくAMDだということだ。
グローバルには、これにより二つの前提が揺らぐ。第一に、すべての推論処理はハイパースケールクラウドに集約されるという通念だ。固定費で導入したアプライアンスが小規模チーム向けに70Bクラスのモデルを実行できるなら、積み重なるトークン課金は「支払う必要のなかった家賃」に見えてくる。第二に、AIの実力はフロンティアモデルにのみ依存するという枠組みだ。検索・要約・コード補完・文書処理といった実務的なワークロードの大部分においては、ローカルシリコン上で動作する優れたオープンウェイトモデルで十分であり、追加クエリの限界コストはほぼゼロに近づく。これはベンダーロックインの力学を変え、バイヤーにクラウド交渉での実質的な交渉力をもたらす。
日本においては、この流れとの親和性が際立って高い。金融・製造・医療・公共セクターを中心とした日本企業は、オンプレミス展開とデータ所在地に対する根強い選好を持ち、機密性の高いデータや規制対象データを海外のクラウドリージョンに送信することへの警戒感も根強い。ローカルAIアプライアンスは、こうした懸念に正面から応える。調達担当チームは、これらのボックスをホビイスト向けハードウェアではなく、コンプライアンスに配慮したAI導入の経路として位置づけるだろう。
SIerにとっては明確なビジネス機会だ。付加価値の源泉は、GPUの再販やクラウドキャパシティの仲介から、モデル選定・量子化・RAGパイプライン・セキュリティ強化・オンプレミス推論クラスターのライフサイクル運用といったインテグレーション作業へと移行する。ガバナンスと監視機能を組み込んだ「ローカルAI in a box」の再現性ある実践を構築した企業は、一度限りのハードウェア販売に継続的なサービス収益を紐付けることができる。また、RPAベンダーやレガシーな自動化チームにとっては説得力のある刷新ストーリーにもなる——脆弱なルールベースのボットを、センシティブなデータをクライアントの社内に留めたままローカルLLMで動作するエージェントに置き換えるというシナリオだ。
日本の開発チームへの注意点は、運用成熟度にある。ユニファイドメモリが取り除くのはハードウェアのボトルネックであり、MLOpsの規律の必要性ではない——パッチ適用・モデル更新・評価・アクセス制御は依然として必要だ。この低コスト化したローカルコンピューティングを、プラグアンドプレイのアプライアンスとして扱うのではなく、規律ある運用と組み合わせた企業こそが、真の競争優位を手にする。




