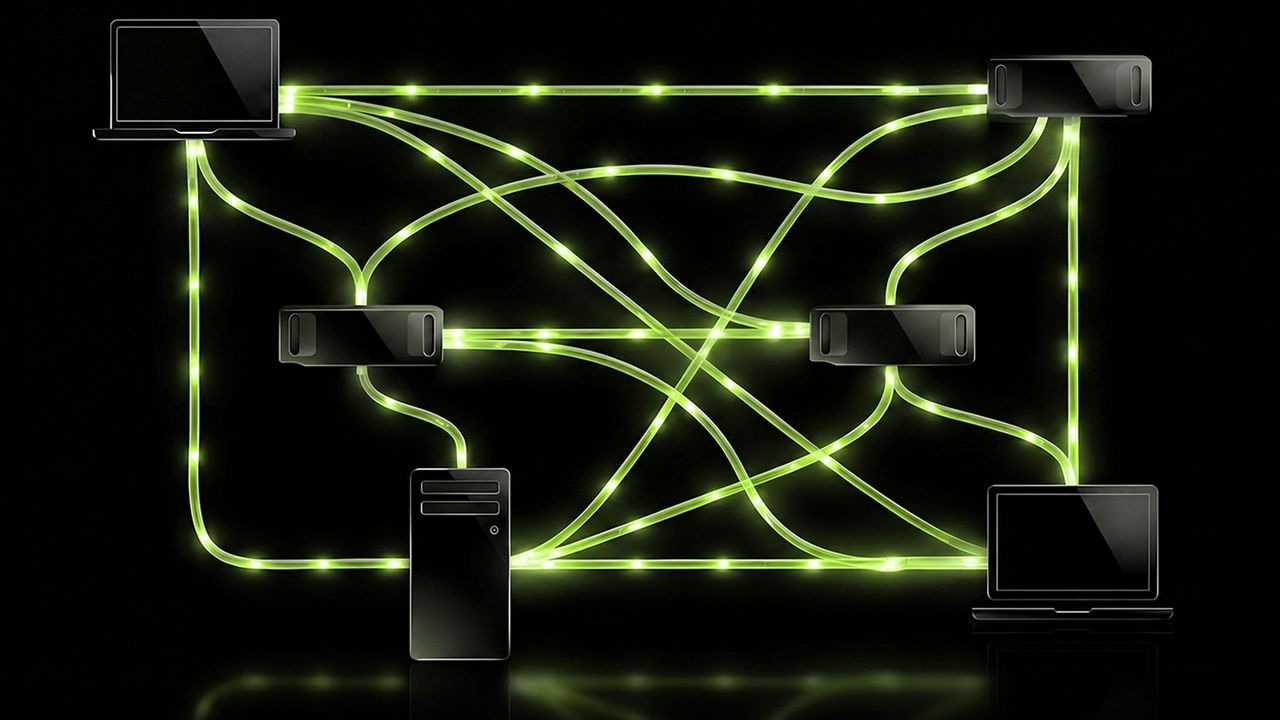
NvidiaのPersonal AI Routerは、家庭内ネットワーク上のすべての余剰GPUを単一のプールに統合してエージェント型ワークロードに対応し、単一のカードに負荷が集中することなく負荷を分散しながら推論をローカルに保つ。このユーティリティ自体は控えめだが、それが示す方向性は決してそうではない。エージェント群が同時モデル呼び出しの数を増やすにつれ、ボトルネックは生のモデル品質からオーケストレーションと利用可能な計算資源へとシフトする。PAIRは、家庭やオフィスに眠るアイドル状態のシリコンがスケジューリングする価値のあるリソースであるという考え方にNvidiaが旗を立てたものだ。
グローバルな意味合いとして、これはクラウド推論の正統派に対する静かなカウンターウェイトである。ローカルクラスターにルーティングされるすべてのトークンは、ハイパースケーラーのメーターに決して触れないトークンであり、デバイス上で実行されるすべてのエージェントは、建物の外に決して出ないデータである。プライバシーに敏感なタスクやレイテンシに制約のあるエージェントループにとって、分散型ローカル推論はコスト計算を再定義する。また、これはNvidiaの堀を予想外の場所で深める。データセンターではなく、コンシューマーおよびプロシューマーGPUの累積インストールベースであり、そこではすでにCUDAが支配的だ。特殊化された推論シリコンに賭けるライバルたちがデータセンターを最適化している間に、Nvidiaは静かにエッジを併合している。
より困難な問題はオーケストレーションの信頼性だ。弾力的で常時稼働の計算資源を前提とするエージェント群は、異種混在の家庭内クラスターのノードがタスク実行中にドロップアウトすると不適切な動作をする。ここでの勝者は、最も多くのカードをプールする者ではなく、分散推論を退屈なほど信頼できるものにする者だ。
日本の企業やSIerにとって、これは今日デプロイする製品というよりも、注視する価値のあるアーキテクチャパターンのプレビューである。金融、医療、公共部門における日本の厳格なデータレジデンシーの期待は、ローカル推論を構造的に魅力的なものにしており、PAIRスタイルのプーリングは、日本のIT調達を依然として形作るオンプレミス志向に見事にマッピングされる。20年間オンプレミス環境を運用してきたSIerは潜在的な優位性を持っている。分散ハードウェアをスケジュール、監視、セキュア化するスキルこそが、エージェント型エッジデプロイメントが要求するものだからだ。
日本の開発チームやRPAベンダーにとってのリスクは、これをホビイストツールと誤解することだ。RPAワークフローはエージェント型置き換えの主要候補であり、もしエージェントがプールされたローカルGPU上で確実に実行できるなら、バックオフィスプロセスを自動化する経済性は再び変化する。国内インテグレーターは、単一ベンダーの管理型推論にデフォルト設定するのではなく、今ハイブリッドアーキテクチャのプロトタイピングを行い、どのエージェントワークロードをプライバシーとコストのためにローカルに留め、どれをクラウドにバーストさせるかを決定すべきだ。戦略的な動きは、ツールがまだ未成熟で競争の場がまだ開かれている間に、ローカル計算資源をファーストクラスのデプロイメントターゲットとして扱うことだ。