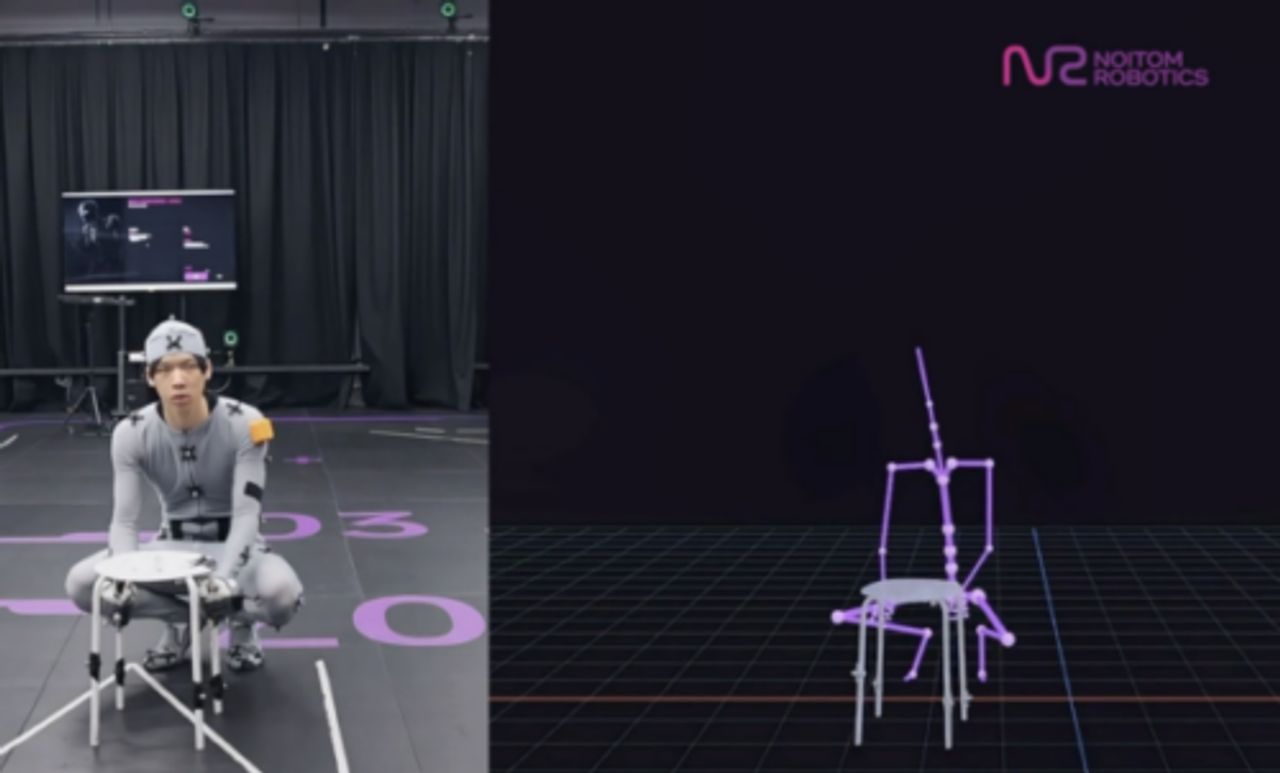
新たな大規模モーションキャプチャデータセットであるHiPHIは、ヒューマノイドロボティクスにおける最も困難な制約、すなわち人間が実際にどのように動き、物体を操作するかに関する高精度データの不足に焦点を当てている。インターネット上の動画は豊富だが幾何学的に不正確であり、従来のモーションライブラリは狭すぎて、ロボットに現実世界で信頼性をもって運搬、押す、引くといった動作を教えることができない。
ここでの戦略的シグナルは、一つのデータセットを超えた意味を持つ。言語と画像のAIでは、堀はアーキテクチャから計算能力へと移行した。Physical AIでは、独自のインタラクションデータへと移行しつつある。モデルは数ヶ月以内にコピーされ、オープンソース化される可能性があるが、物体の軌跡やメッシュと同期した全身モーションは、収集に時間がかかり、コストが高く、物理的である。最も豊富な人間と物体のインタラクションのライブラリを蓄積する者がペースを設定することになる。なぜなら、強化学習ポリシーはデータ規模とともに向上し、そのデータがハードウェアに転送できるほど正確な場合にのみsim-to-realギャップを越えるからだ。収集を構造化するために行動の言語的フレームワークを使用することは、示唆的である。この分野は、カバレッジが日和見的ではなく体系的でなければならないことに気づきつつある。
日本にとって、これは自然な優位性であると同時に警告でもある。日本はFanuc、Yaskawa、Toyota、Hondaなどの企業を通じて、産業用ロボティクスと精密ハードウェアにおいて比類のない基盤を有しており、物流、高齢者介護、製造業における深刻な労働力不足に直面しており、ヒューマノイドはそれに対処するためのものである。その需要は現実的かつ持続的である。しかし、ハードウェアのリーダーシップが自動的にデータのリーダーシップに転換するわけではない。日本のメーカーがアクチュエータと信頼性で競争を続ける一方で、米国と中国のプレイヤーがインタラクションデータのパイプラインとその上の学習スタックの構築に走れば、日本はボディを供給する一方で、他者が頭脳を所有するリスクがある。
SIerと企業ITチームにとって、その含意は価値がどこに存在するかのシフトである。ヒューマノイドの導入は調達作業ではなく、データ運用の規律となる。勝利するインテグレータは、クライアントの倉庫や生産ラインでタスク固有のインタラクションデータをキャプチャし、それに対してポリシーを微調整し、sim-to-real検証ループを安全に管理できる者となる。これは、今日のSIerビジネスを定義するシステム構築やRPA作業とは異なる筋肉であり、ターンキープラットフォームを待つのではなく、今からモーションデータキャプチャとロボット学習MLOps実践を構築し始める企業に報いる。データ収集を一回限りのコストではなくコアインフラとして扱う企業が、次の自動化レイヤーを定義することになる。