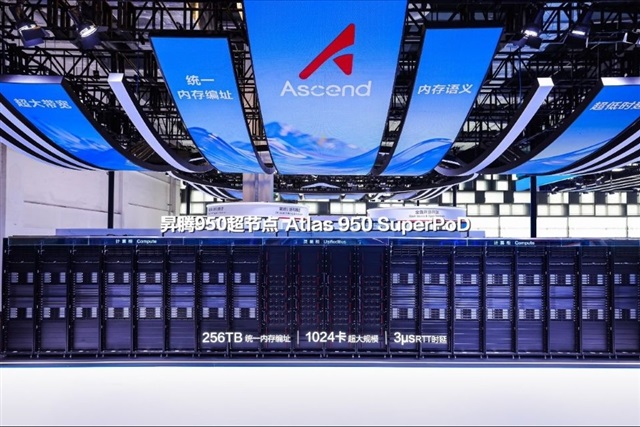
核心となるシグナルはシンプルだが重大だ。中国のNvidia対抗勢力となり得るメーカーが、高帯域幅メモリの不足と高騰を受けて、現行世代および次世代アクセラレータの価格を引き上げている。
戦略的な解釈としては、HBMこそがロジックダイではなく、現在AI演算における制約要因となっているということだ。中国の国産シリコンは輸出規制を回避するより安価な道筋となるはずだったが、欧米に供給しているのと同じ3社寡占のHBM市場が中国の野心をも制限している。アクセラレータに供給するメモリが配給制になると、名目上は自主的なチッププログラムであっても輸入ボトルネックを継承することになる。これらのベンダーの価格上昇は、価格決定力の表れというより、薄い供給と低い歩留まりが購入者に直接転嫁されていることを示している。より広い意味では、2025年以降までハイパースケーラーによって厳しく予約されているHBM割り当ては、リソグラフィー制限と同じくらい強力な地政学的手段となる。メモリキューを制する者がAI展開のペースを制するのだ。
あらゆる場所の購入者にとって、重要な点は演算コスト曲線が予定通り下向きに曲がっていないということだ。HBMがゲーティング要素となっている場所では、アクセラレータの不足と価格インフレが続くと予想され、フロンティアモデルと推論構築のあらゆる設備投資想定を再構築することになる。
日本にとって、この角度は両面性を持つ。プラス面では、これは材料と装置の話であり、日本のサプライヤーは先端パッケージング用化学薬品やフォトレジストからボンディングやテストツールまで、HBMスタック深くに位置している。より厳しいHBM需要とより複雑な積層メモリへのシフトは、日本企業が構造的ポジションを持つプロセス材料への需要を強化し、国内ファウンドリとパッケージング投資の論理を補強する。
マイナス面では、AIインフラを構築している日本企業やSIerは、供給を事前予約したハイパースケーラーよりも調達力が弱い中で、同じメモリ駆動のコストインフレに直面している。生成AIやRPA近代化プロジェクトを計画しているシステムインテグレーターにとって、これはGPUサーバーのリードタイムと単価を固定的な項目ではなく、変動する投入要素として扱うべきことを意味する。実用的なヘッジは、演算ポータビリティを前提に設計し、生のアクセラレータ数よりも推論効率とモデルの適正規模化を優先し、キャパシティコミットメントを早期に確保することだ。今後18カ月で勝つチームは、チップ不足ではなくメモリ不足を真の計画変数として扱ったチームとなるだろう。




