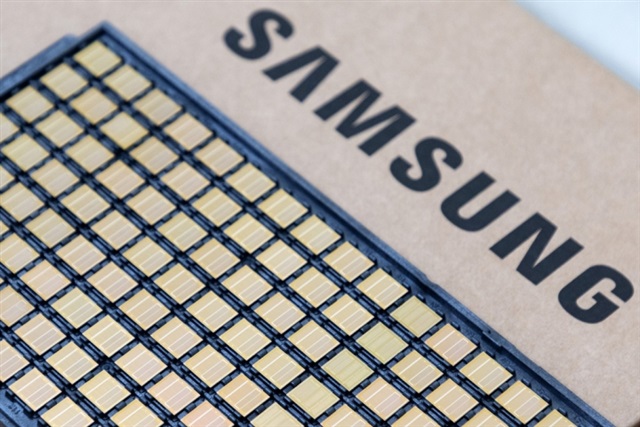
NvidiaはSamsungとSK HynixにVera Rubin向けHBM4のうち8段積層の比率を引き上げるよう要請した。スタック当たりの最大容量よりもパッケージング歩留まり、熱余裕、供給可能性を優先する判断だ。この動きは技術的な脚注ではなく、現在AI計算のロードマップを実質的に支配しているのが誰か――それはメモリメーカーである――を示す兆候に他ならない。
長年、GPUがAIの進化を律速するという見方が支配的だった。だがこの構図はもはや時代遅れだ。高帯域幅メモリこそが制約要因となっており、12段積層ではなく8段積層を受け入れる姿勢は、Nvidiaがスペックシート上の見栄えよりも実際に量産可能なものへ最適化していることを示す。より高い積層は熱収支を圧迫し先端ノードでの歩留まりを低下させるため、野心を抑えることで予測可能な供給を確保する。ハイパースケーラーやモデル開発研究所にとって戦略的な含意は不都合なものだ。アクセラレータの納期スケジュールは、SK Hynixが先行し、Samsungが認定獲得に奮闘し、Micronが加わる寡占市場に人質に取られている。最速チップを設計した者ではなく、HBM割り当てを確保した者が最先端の訓練ペースを決める。
これは競争力学も再編する。8段積層へのシフトは認定サプライヤーの裾野を広げNvidiaに交渉力をもたらすが、AMDやカスタムシリコンプログラムが追求するGPU当たりメモリ容量の天井を制限する。2026年の市場シェアを決めるのはアーキテクチャではなくキャパシティになるだろう。
日本にとって、この読み筋は直接的かつ好都合だ。同国はまさに争点となるチョークポイントの川上に位置する。フォトレジスト、高純度薬品、ボンディングとパッケージング材料、そして先端積層とハイブリッドボンディングに使われる精密装置である。歩留まりとパッケージングが律速変数となれば、どのメモリベンダーがソケットを獲得しようとも、需要は日本の材料・装置サプライヤーに集中する。これは特定のファウンドリ顧客に賭けるよりも構造的に強固な立ち位置だ。
日本企業、SIer、社内AI部門にとって実践的な教訓は調達規律である。HBM不足はVera Rubinサイクルを通じてGPUの納期と価格を不安定にし続ける。希少な最上位アクセラレータの行列に並ぶのではなく、国内インテグレーターはメモリ階層を柔軟に使い分けるワークロード設計、推論最適化と量子化デプロイメントへのより強い依存、オンプレミス納入遅延に対するヘッジとしてのクラウドGPUキャパシティの活用を進めるべきだ。供給制約を一時的な不足ではなく恒常的な条件として計画するチームが、競合が列に並んで待つ間にAIプロジェクトを出荷する。




