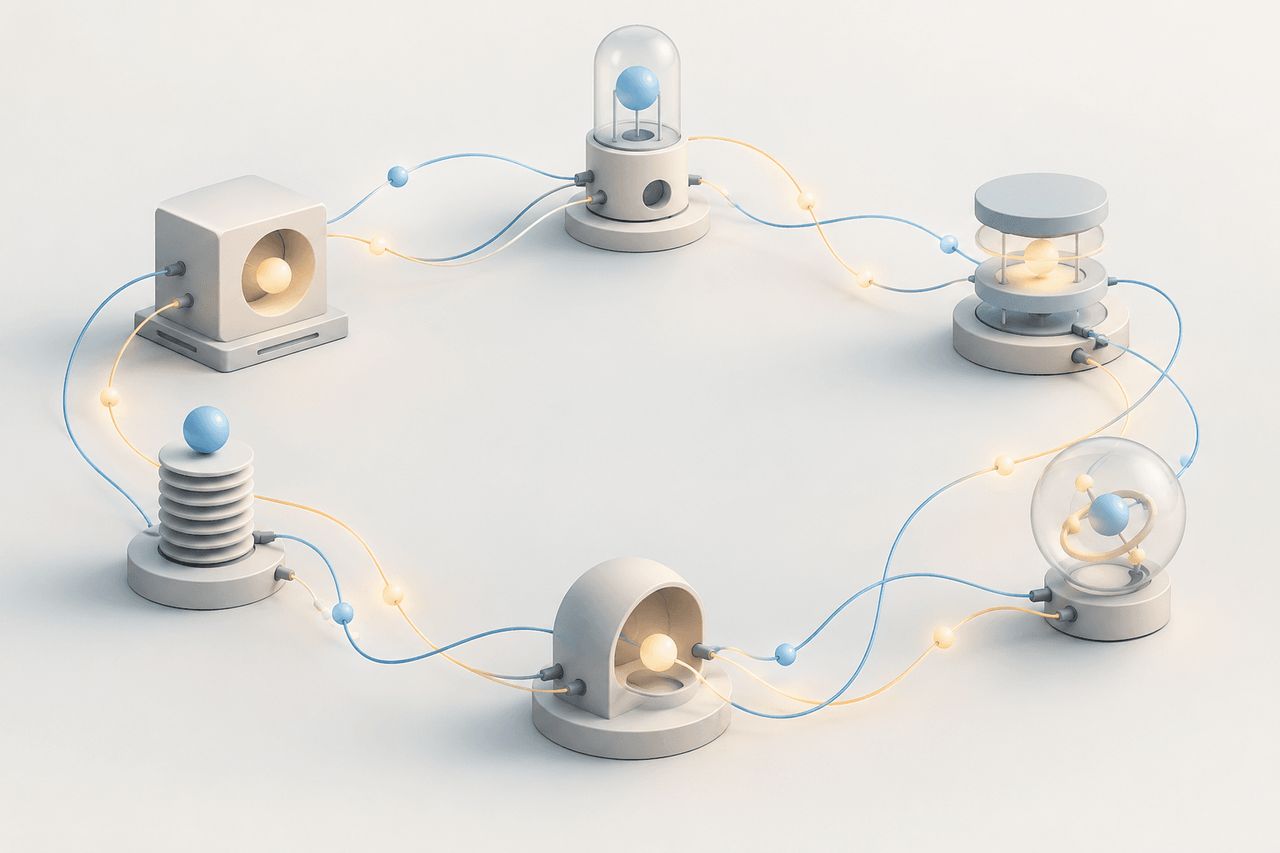
GPUWorksは、Huawei Ascend、T-Head PPU、Hygon、そしてNVIDIAアクセラレータを単一クラスタ内でプールする40MBの推論プラットフォームをApache-2.0ライセンスでリリースした。開発者によれば、1台のコントロールサーバーが1,003台のGPUマシンを調整したという。この見出しの数字自体よりも重要なのは、アーキテクチャ上の賭けだ。推論が特定ベンダーのシリコンから切り離されつつある。
これは構造的な問題への直接的な対応である。輸出規制により、中国の事業者は国内製チップと既に保有するNVIDIAハードウェアの寄せ集めを抱えており、単一のランタイムでは互換性がない。異種アクセラレータを代替可能な1つのプールとして扱うスケジューラは、稼働率を高め、調達ギャップを平準化し、入手可能なものを購入することのペナルティを軽減する。小型で寛容なライセンスのバイナリとしてパッケージ化することで、採用障壁をほぼゼロまで下げる。これこそ、既存企業が対応する前にオープンなインフラプロジェクトが普及を勝ち取る方法だ。
戦略的ターゲットはCUDAである。NVIDIAの持続的な優位性は、生のシリコン単体にあったことはない。それは、スイッチングコストを懲罰的にするソフトウェアの引力だ。ハードウェアを抽象化するオーケストレーション層は、まさにその引力を侵食する。推論層に今流れ込んでいる資本は、Falが報じられた13億ドルの調達で160億ドルの評価額を得たことに象徴されるように、モデル提供の経済性こそが、トレーニングではなく次のマージン戦争が展開される場所であることを裏付けている。スケジューリング層を支配する者が、推論ワークロードが物理的にどこに配置されるかを支配する。
日本の企業とSIerにとって、これは具体的な関連性を持つ。国内チームは同じGPU不足と深刻なNVIDIA依存に直面しており、今ではそれが国内で計算リソースを保持したいという主権AI課題によってさらに複雑化している。ベンダー中立のプーリング層により、SIerは政府や規制対象のクライアント向けに、1つのサプライヤーのロードマップや価格設定に全資産を賭けることなく推論プラットフォームを構築できる。また、RPAや自動化ベンダーに、新規の設備投資ではなく、混在した既償却済みハードウェアを使用して、既存のワークフローにローカルLLM推論を組み込む道を提供する。
ただし、本番環境での成熟度には注意が必要だ。異種アクセラレータのプーリングは、レイテンシのばらつき、デバッグの複雑さ、エンタープライズ購入者がほとんど許容しないサポートギャップを招く。日本の調達チームは、これをドロップイン型の代替品としてではなく、スタックがどこに向かっているかのシグナルとして扱い、1サイクル遅れてベンダーロックインを再議論することにならないよう、今から抽象化層の評価を始めるべきだ。