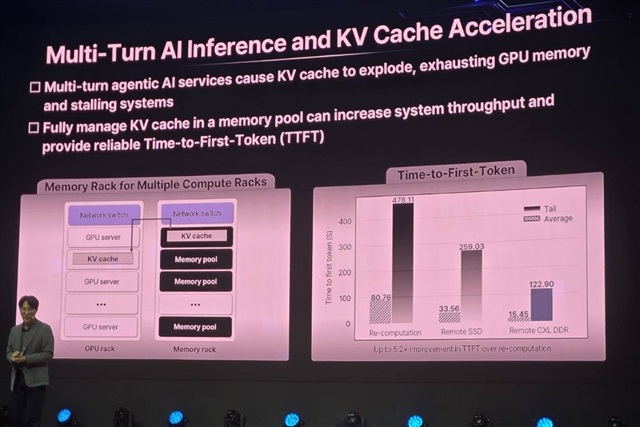
SK HynixとIntelは、エージェント型ワークロードが帯域幅と容量を圧迫する中、Compute Express Link(CXL)などのインターコネクトを活用してAIクラスター全体でメモリをプールする、メモリ中心のサーバーアーキテクチャについてエコシステムパートナーと協業している。技術的な節目という意味合いを超え、このタイミングは世界のAIインフラの経済性における重要な転換を反映している。これまでのサイクルでは、ハイパースケーラーは力任せの調達によって容量のボトルネックを解消し、搭載された広帯域メモリ(HBM)を利用するためだけに高利益率のGPUサーバーを丸ごと購入してきた。そうした青天井の投資時代は摩擦に直面している。大手金融機関がAIインフラ構築の投資対効果に疑問を呈し、SoftBank'sの通信子会社などの通信事業者が米国のAIデータセンター需要減速の可能性を指摘する中、最高財務責任者(CFO)らは既存の半導体資産の稼働率向上を求めている。
エージェント型AIは、このアーキテクチャ上および財務上の緊張をさらに高めている。ステートレスなチャットボットとは異なり、自律的に複数ステップを実行するエージェントは、永続的なコンテキストウィンドウ、長期的な状態保持、そして異なる計算ノード間での高速なメモリの受け渡しを必要とする。メモリを個々のプロセッサに厳密に紐付けると、アイドル状態のホスト上に膨大なDRAMプールが取り残される一方で、稼働中の推論ノードではメモリ不足が生じる。メモリを計算処理から切り離すことで、SK HynixとIntelはCXLベースのメモリプーリングを設備投資疲れに対する構造的なヘッジと位置付けている。データセンター事業者は、高価なアクセラレータを過剰に配備することなく、独立して容量を拡張できるようになるからだ。Intelにとって、オープンなメモリプーリング規格を推進することは、買い手を単一ベンダーのサーバーラックに囲い込む独自の垂直統合型インターコネクトに対抗する戦略的な楔にもなる。
国内のクラウドプロバイダー、通信キャリア、そして一般企業が深刻な電力制約と円建てのハードウェア価格高騰に直面している日本市場において、分離型メモリはインフラ戦略を塗り替えるものとなる。東京や大阪周辺に一極集中し、メガワット単位の厳しい電力上限を抱える日本のデータセンターには、低稼働率のサーバーを無秩序に増設する余裕はない。ソブリンクラウド環境やオンプレミスの企業向けAIクラスターを設計する日本の大手システムインテグレーター(SIer)は、ハードウェアのサイジングを見直す必要があるだろう。社内RPAの置き換えやマルチエージェント型の業務ワークフローに対し、モノリシックなGPUアプライアンスを提案する代わりに、SIerはハードウェアの減価償却サイクルを延ばすモジュール式のメモリ重視型トポロジーを構築できる。
ステートフルな企業向けエージェントを構築する日本の開発チームやインフラチームもまた、ソフトウェア層での適応が求められる。共有メモリプールはローカルのHBMと比較して不均一なレイテンシ階層をもたらすため、エンジニアリングチームやSIerのミドルウェア部門は、エージェントの応答時間を劣化させることなく実質的なコスト削減を引き出すべく、キーバリュー(KV)キャッシュの配置やメモリのオーケストレーションを最適化する必要がある。