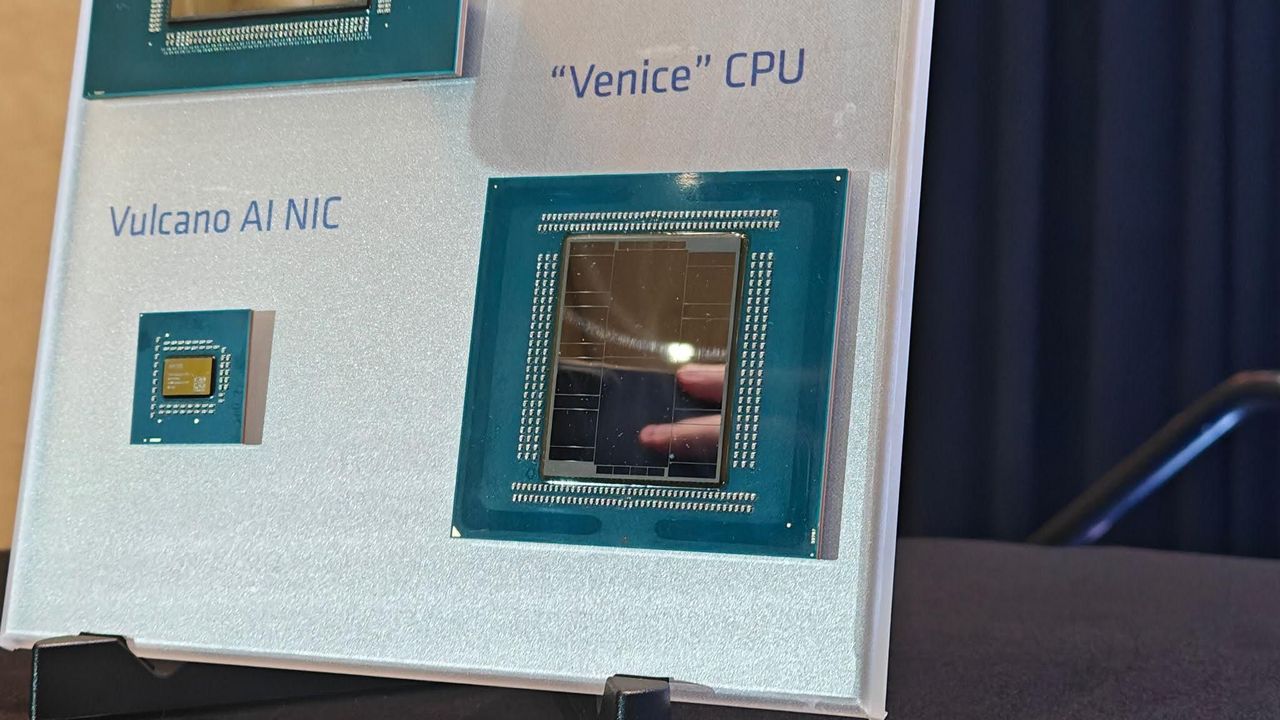
AMDは、EPYC 'Venice'の初の公式ベンチマーク結果をNvidiaへの直接的な挑戦として公表し、256コア製品がNvidiaのVeraシリコンの2倍以上の速度で、コアあたり性能も約20%高いと主張している。マーケティング文句を取り払えば、戦略的メッセージは明確だ。データセンターCPUは、もはやGPUの隣に置かれる汎用品的な付属品ではない。争奪戦の戦場になりつつある。
重要な文脈は、Nvidiaが純粋なアクセラレータベンダーからフルスタックシステム企業への転換を図っていることだ。VeraはNvidiaの次世代ArmベースホストCPUで、同社のGPUと緊密に統合されている。AMDがVeniceをVeraと直接比較することで、AIラック内のx86ホストプロセッサの地位を守り、ノード全体をNvidiaの垂直統合設計に明け渡さない意図を示している。コアあたり性能の主張が重要な手がかりだ。AIトレーニングと推論クラスタは、単純な演算能力だけでなく、データ移動とオーケストレーションでボトルネックに直面することが増えており、アクセラレータに供給するCPUが実際の経済的重要性を持つ。ベンダー提供のベンチマークは独立検証が出るまで常に懐疑的に見るべきだが、このフレーミングはAMDが利益源の移行をどう見ているかを明らかにしている。
業界全体にとって、これは三つ巴の圧力を強める。Nvidiaはノードをエンドツーエンドで支配したい、AMDはホストとしてのx86の関連性を維持したい、そしてハイパースケーラーのArmベースカスタムシリコンが両者を侵食し続けている。勝者は、ラックスケールでワットあたり・ドルあたりの最高性能を提供する者だ。電力と冷却が総所有コストを支配するようになったからだ。
日本市場への影響は、インフラ経済学を通じて波及する。主権的AI能力を構築する国内クラウドや通信事業者、そしてこれらの環境を設計・統合するSIerは、AMDとNvidiaがホストCPUで真っ向勝負することで交渉力を得る。CPU層での競争激化は、これらのインテグレータが提供する企業にとって、より良い価格設定とロックイン減少を意味する。また調達も複雑化する。SIerはもはやホストプロセッサをデフォルトの項目として扱えず、単一ベンダースタックに頼るのではなく、ワークロード固有の性能と消費電力をモデル化する必要がある。
日本独自のシリコン戦略にとっても戦略的な角度がある。国内HPC取り組みの基盤となるArmアーキテクチャは、Nvidiaが現在商業的に推進しているのと同じ設計路線にあり、一方x86はほとんどのエンタープライズデータセンターで現職のままだ。複数年のAIインフラ投資を計画する日本企業は、ホストCPU層を所与のものではなく能動的な意思決定として扱い、設計にベンダー柔軟性を組み込むべきだ。見出しの主張を信じるのではなく、実際のワークロードに対してベンチマークを行うチームが、この競争が展開する中で最大の価値を引き出すだろう。