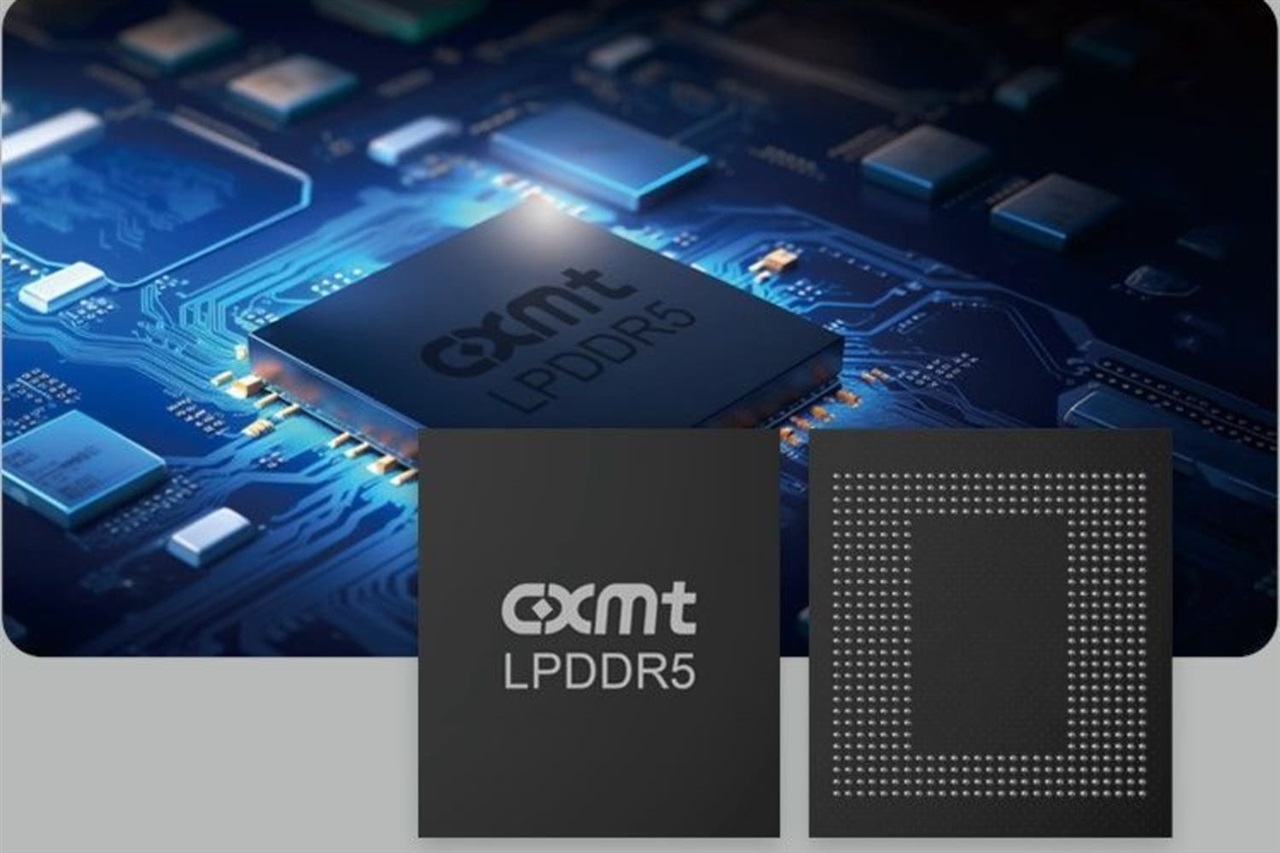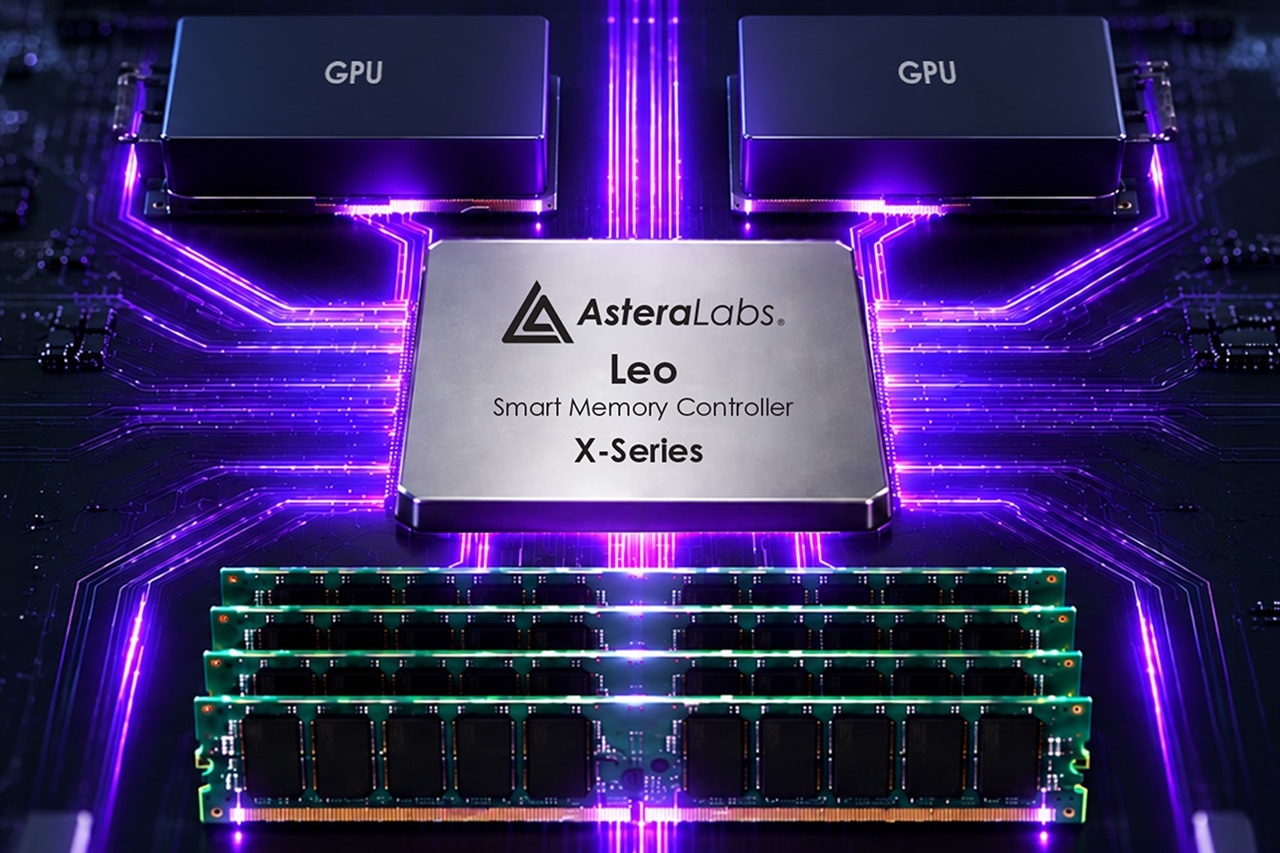
Astera Labsは、AIが単一クエリからエージェントが連続ループを実行する方式へと移行する中で鮮明になる問題に対処するため、Leoメモリコントローラーラインを拡張した。その問題とは、キーバリューキャッシュがアクセラレータ上のHBMを超えて肥大化し、通常のフォールバック手段がかえってレイテンシを悪化させるというものだ。
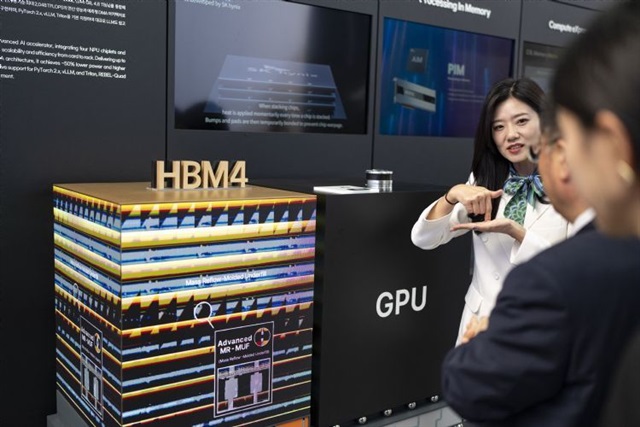
この2年間、業界はAIの進歩をGPU FLOPSで測定してきた。エージェント型ワークロードはその計算式を静かに書き換えつつある。長いコンテキストにわたって推論し、ツールを呼び出し、多数のターンにわたって状態を維持するエージェントは、増大するKVキャッシュを高帯域幅メモリに常駐させ続ける。HBMはスタック内で最も希少で最も高価なリソースであり、キャッシュがオーバーフローすると、システムは低速メモリにスピルオーバーし、スループットの崩壊を目の当たりにする。制約となるボトルネックは、チップがどれだけ高速に計算できるかから、メモリ階層がどれだけ効率的に状態を保持・移動できるかへとシフトしている。だからこそ、コントローラーとインターコネクトのプレイヤーが配管ではなく戦略的存在に突如なったのだ。
商業的帰結として、価値が発生する場所の再編成が起きている。ピーク計算能力ではなくメモリ容量と帯域幅が推論の経済性を左右するなら、エージェント提供のコストはGPU数と同程度にメモリオーケストレーションの関数となる。クラウドプロバイダーは、より多くのアクセラレータを購入せずにエージェント単価を削減するレバーを獲得し、階層型メモリアプローチ(レイテンシを維持しながらキャッシュを安価なプールにオフロードする)は、すべての推論プラットフォームが必要とする設計パターンになる。また、より多くのシリコンが常に答えであるという前提にも圧力がかかる。
日本企業とSIerにとって、これは総所有コストに直結する問題だ。日本企業がAIを導入する際はコストに敏感で、暴走するクラウド料金に慎重になる傾向があり、エージェント型推論はまさにその料金が予測不能に膨張する分野だ。オンプレミス対クラウド推論について助言するSIerは、GPU調達だけでなく、メモリアーキテクチャを第一級の設計判断として扱うべきだ。キャッシュ動作とメモリ階層化を理解するチームは持続可能なエージェント単価経済性を提示できる。GPUだけでシステムを設計するチームは、実行時の請求額に驚くことになるだろう。
日本のメモリ遺産にとってのサプライチェーン的解釈もある。推論需要がメモリ容量とスマートなコントローラーに傾くにつれ、日本のコンポーネントおよびストレージプレイヤーは、GPU中心の物語が示唆していたよりも価値の近くに位置する。ルールベースのボットからエージェント型ワークフローへ移行する国内RPAおよび自動化ベンダーにとって、教訓は明確だ。差別化要因は、エージェントを大規模かつ手頃なコストで実行することであり、それは今やモデルの問題と同程度にメモリの問題なのだ。