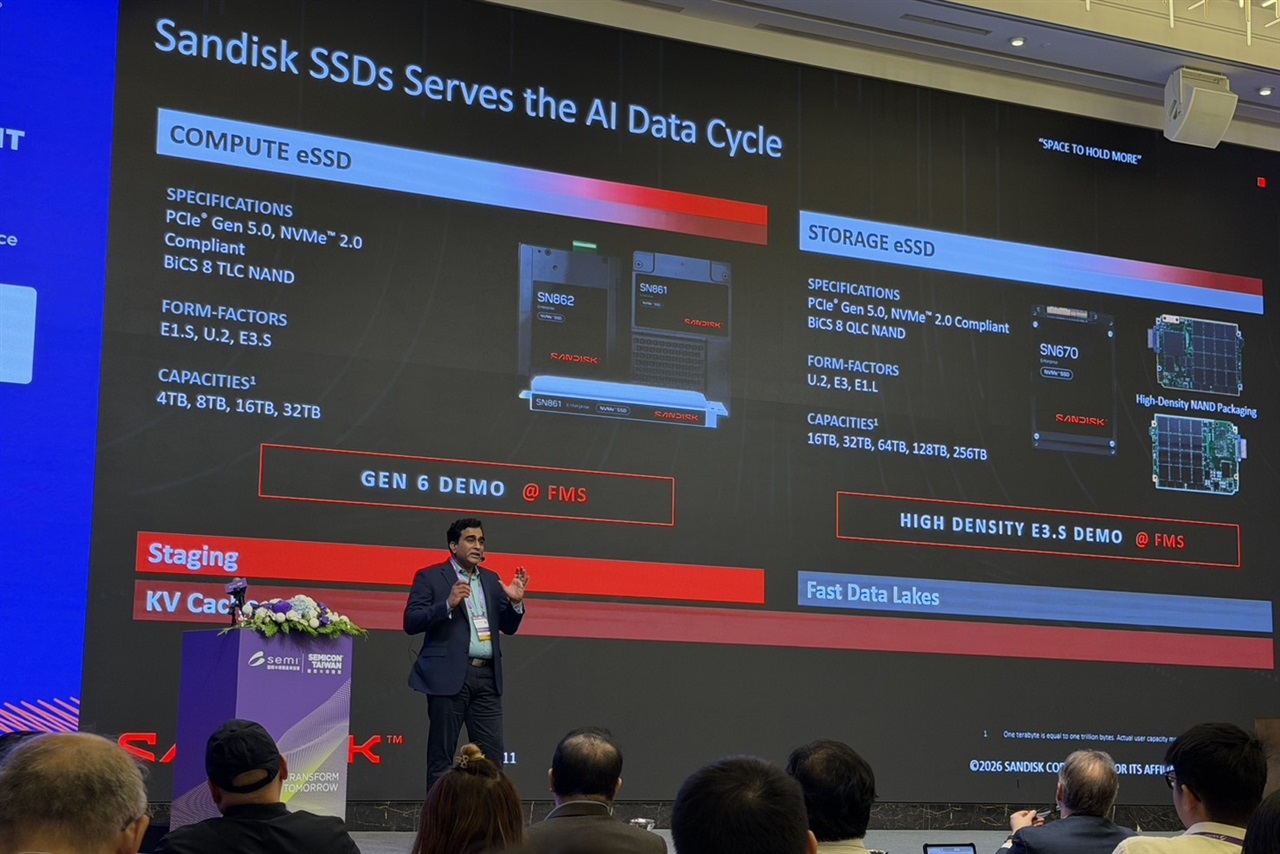
今週の半導体関連シグナルは、単一の構造的ボトルネックを指し示している:高帯域幅メモリだ。注目はGPU配分に向けられ続けているが、HBM供給がAIデータセンター拡張の制約条件となりつつあり、これを取り巻く業界は価格引き上げ、先進パッケージングの加速、製造能力への資本投下で対応している。その底流は個別項目以上に重要だ。コンピュート不足は、ロジックダイからメモリスタック、そしてそれらを結合するパッケージングラインへと移行している。
グローバルな意味合いは、AI経済を誰が支配するかの再編成だ。HBMと先進パッケージング(CoWoSクラスの統合)が希少な投入材である場合、価格決定力は一握りのメモリメーカーとファウンドリに集中する。TSMCの値上げはTSMCに留まらず、アクセラレータベンダーを通じて、ハイパースケーラーや企業が最終的に支払うトークン単価へと波及する。Amazonが今四半期に報告したcapex規模は、需要が問題ではないことを示している。その需要が予測可能なコストとリードタイムで満たされるかどうかが問題だ。調達期間の長期化、複数年の供給確約、早期に配分を確保した企業へのプレミアムが予想される。
並行する動きがこのシフトを強化している。GoogleがTPUフットプリントを拡大していることと、ドメイン特化モデルへの広範な推進は、どちらも汎用GPUへの依存を減らすものであり、これは単なる性能追求だけでなく、部分的には供給リスクヘッジである。アクセラレータのオープン市場が配給制の時、垂直統合とカスタムシリコンは合理的選択となる。
日本企業やSIerにとって、実務的なエクスポージャーはモデル選択ではなく、コストとタイミングだ。クラウド契約やオンプレミスGPUクラスタを通じてAIインフラを構築する企業は、アクセラレータとHBM連動価格が次の調達サイクルを通じて高止まりし変動すると想定すべきであり、現在の見積もりを安定的なものとして扱うのではなく、その想定をTCOモデルに織り込むべきだ。AIプラットフォーム展開を助言するSIerは、ここで具体的な責務を負う:本当にフロンティアアクセラレータを必要とするワークロードと、より小規模な特化モデルや推論最適化インスタンスで対応できるものを分離すべきだ。なぜなら、制約されたサプライチェーンに対する過剰プロビジョニングこそ、予算が静かに破綻する場所だからだ。
日本はまた、注目に値するサプライサイドの立場も保持している。国内の材料、パッケージング、装置プレイヤーは、まさに今需要が高まっているパッケージングとメモリ増強の上流に位置しており、これは下流インテグレータの投入コストを引き上げる一方で、そのセグメントにとっては追い風だ。国内開発チームにとって、実務的な教訓は効率規律だ:モデルサイズの適正化、キャッシング、バッチングは最適化ではなくコスト管理となる。基盤ハードウェアが支出意欲ではなくメモリによって配給される時、それらは必須のコントロールとなる。