DeepSeek は 6 月 1 日から V4 Pro API 価格を恒久的に 75% 引き下げ、入力を 100 万トークンあたり約 0.435 ドルに設定する。これは最先端の米国ラボの何分の一かにすぎない。しかし価格は二次的であり、その背後にあるアーキテクチャこそが本当の物語だ。
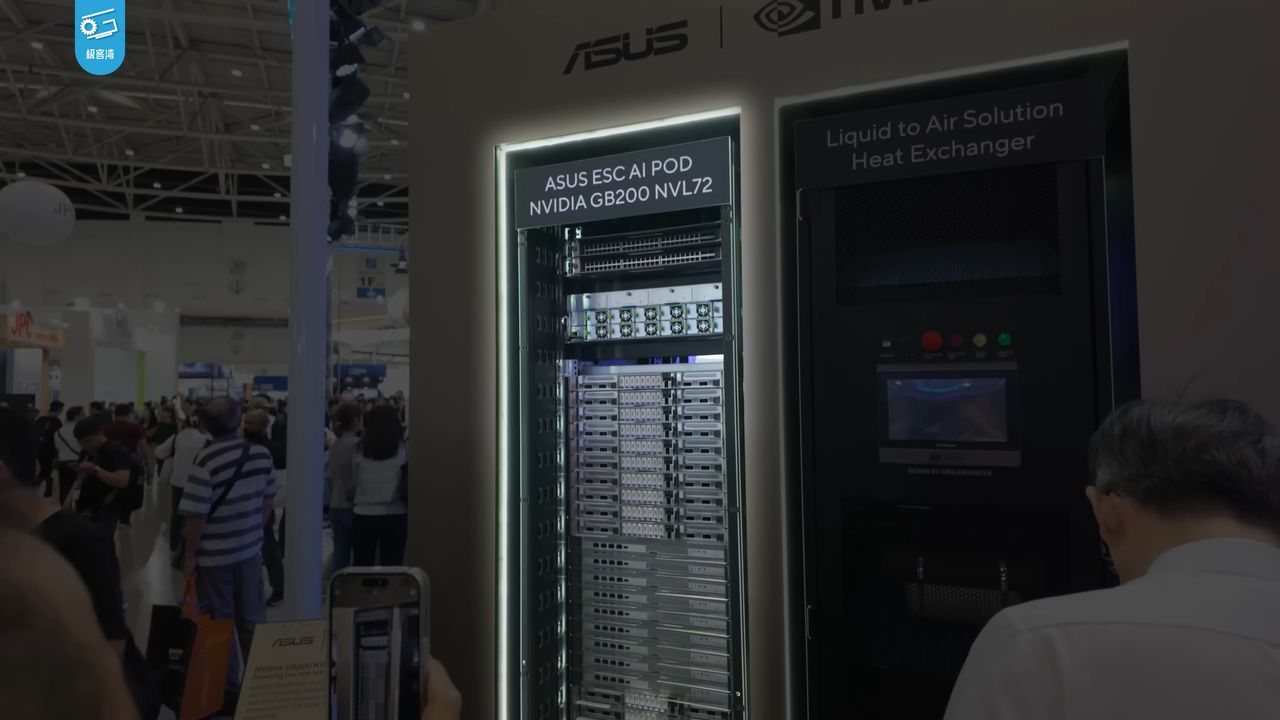
コンセンサス化した AI ハードウェアスタックは、単一の chokepoint' の上に築かれてきた。高帯域幅メモリである。推論では会話の文脈を KV キャッシュに保持する必要があり、そのキャッシュは高価で供給制約のある HBM に置かれてきた。これが NVIDIA's の最上位 GPU を不可欠かつ希少にしている資源だ。GB200 のリードタイムが今や複数四半期に伸びるなか、その希少性は業界の拘束条件になった。DeepSeek's が KV キャッシュを 6GB 未満に圧縮できると報じられていることは、同等モデルで数十 GB を必要とする状況に対して、推論を HBM に縛られた問題から、NAND、LPDDR、SSD で解ける階層型メモリとスケジューリングの問題へ再定義する。
この設計思想が広がれば、AI 建設の経済的重心は移る。現在の winner's circle、すなわち NVIDIA、SK Hynix、Samsung、Micron's HBM ライン、そして HBM 波に乗るシリコンウエハーサプライヤーは、需要成長が複利的に加速するのではなく減速するシナリオに直面する。逆に、NAND 比重の高いプレイヤー(Kioxia、Micron's フラッシュ事業)、LPDDR ベンダー、自動車・産業市場向けなどのエッジ推論 SoC 設計企業は、これまで締め出されていた AI ワークロードへ入る現実的な道を得る。国内および代替 GPU の取り組みも恩恵を受ける。推論、キャッシュ、ストレージで層ごとに競う方が、NVIDIA's フラッグシップを正面から追うよりはるかに安いからだ。
戦略的意図は市場シェアより大きい。安価でハードウェア柔軟な推論をデフォルトにすることで、DeepSeek は単なるモデルベンダーではなくインフラ標準設定者として自らを位置付け、開発者、企業、チップメーカーを自社スタックへ引き寄せている。これは AWS と Android が実行したのと同じプレイブックだ。自分の上のレイヤーをコモディティ化し、重要なレイヤーを支配する。
経営層へ:単一ベンダー GPU 依存を調達の細部ではなく戦略的リスクとして扱うべきだ。推論調達を NAND、LPDDR、代替アクセラレーターへ多様化し、MoE と潜在注意圧縮への R&D に資金を投じて推論コスト構造を下げ、生の学習能力から効率的な推論インフラへ資本を再配分する。流通している 10 兆ドルという数字は投機的だが、方向性への賭け、つまり学習規模ではなく推論経済性が次の 10 年を決めるという見方は妥当である。




