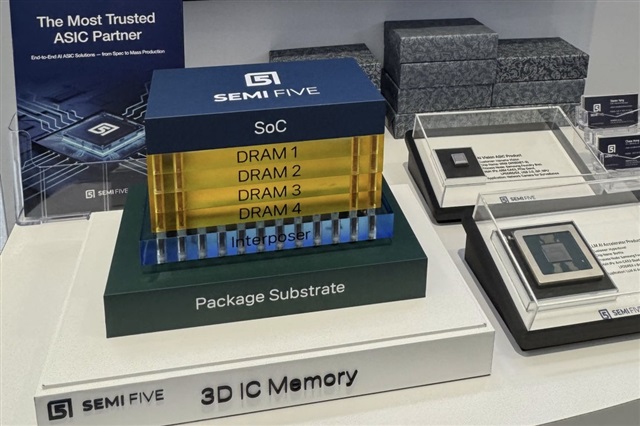
SEMIFIVEは、HyperAccelのデータセンター推論アクセラレータをSamsung Foundryの4nmノードで量産体制に移行した。これは同社にとって同プロセスでの初の大規模稼働となるが、その時期はSamsungのSF4ラインがフル稼働状態にある。重要なのはテープアウトそのものではなく、そのタイミングである。最先端スロットが今やAIシリコン経済における制約条件となっている。
ここでの戦略的な物語は、AI演算の静かな二極化である。学習が見出しとNVIDIAの利益率を独占する一方、推論こそが継続的コストの発生源であり、すべてのハイパースケーラーと潤沢な資金を持つモデル研究所は今、汎用GPUから脱却し、大規模に一つの仕事を安価にこなす専用アクセラレータへと移行しようとしている。SEMIFIVEのようなカスタムシリコン企業は、この移行の武器商人であり、ファブレス設計のアイデアを、顧客がファウンドリ関係を所有することなく出荷可能な製品に変える。2年前には設計問題だったものが、今日ではキャパシティ配分の問題になっている。
これはSamsung対TSMCの競争を再定義する。TSMCの最先端は事実上売り切れ状態であり、Samsungで信頼できる利用可能な4nmの選択肢は、わずかなPPA上の優位性よりも価値がある。トップティア購入者以外のすべての企業にとって、2026年の真の問いは、どのノードが最良かではなく、どのファブが実際にウエハーを供給してくれるかである。プロセスリーダーシップだけでなく、キャパシティこそが堀となりつつある。
日本にとって、これは不快な鏡像である。Rapidusへの国家的賭けと、国内最先端能力を再構築するより広範な推進は、プロセスを所有することが賞品だと想定している。しかし、このプログラムは、欠けている層が、日本のファブレス構想を生産部品に変える設計サービスとIP統合エコシステムであることを示している。日本は強力な材料、装置、パッケージングのポジションを持つが、カスタムSoCの中間層は薄い。こうしたシリコンプラットフォーム企業の国内同等品がなければ、日本のAIチップの取り組みは、国内で何が構築されようとも、韓国や台湾の設計パートナーと海外のファブスロットに依存するリスクがある。
SIerとエンタープライズITチームにとって、短期的なシグナルは製造ではなく調達である。量産段階に入る推論最適化アクセラレータは、GPUを超える選択肢を広げ、最終的にはシステム統合契約に組み込まれるAIサービスのユニットエコノミクスに圧力をかけるはずだ。単一のGPUベンダーを前提とするのではなく、今からマルチシリコン推論アーキテクチャのモデリングを開始するチームが、供給が緩和した際に価格優位性を握るだろう。