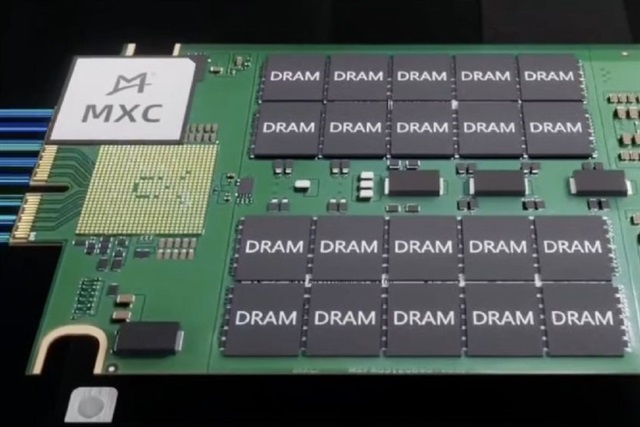
大規模AIクラスターにおける真のボトルネックは、もはや生の計算能力ではなく、アクセラレーター間の配管である。レーン当たり400Gb/sを実現し、現在の200Gレーン当たりモジュールの約4倍の帯域幅密度を約束する高密度プラガブル光モジュール形式を共同開発することで、NVIDIAとCiscoは、トレーニングスループットを密かに制限するインターコネクトの壁に攻勢をかけている。戦略的な含意はスペックシート以上に興味深い。NVIDIAはGPUを超えて、GPUを結びつけるファブリックへと支配を拡大しており、一方のCiscoは、Aristaやマーチャントシリコンスイッチングに対して苦戦してきたAIファクトリーの席を獲得している。
グローバルには、これはマージンがどこに発生するかのシフトを示している。クラスター規模が拡大するにつれ、光モジュールとスイッチングはデータセンター設備投資全体に占める割合が増大し、その電力予算の支配的なシェアを占めるようになる。帯域幅密度と電力効率を同時に改善するあらゆる形式は、ハイパースケーラーやネオクラウドにとってのトークン当たりコストの計算を直接変化させる。また、購入者にとって馴染みのある問題も提起する。緊密に統合されたNVIDIA-Ciscoスタックは今すぐパフォーマンスを提供するが、ベンダーロックインを深め、多くの事業者が次のサイクルに賭けているオープンEthernetや共同パッケージ光モジュールの勢いに逆行する。
日本にとって、機会は上流にある。日本のサプライヤーは、あらゆるプラガブル形式が依存する光部品——レーザー、変調器、フォトニックデバイス、精密コネクタ——において真の強みを持っている。400Gレーン当たりへの移行は、日本の精密製造業が競争力を持つまさにその部品において技術的なハードルを引き上げるが、これらの企業が遅れて反応するのではなく、早期に認定サプライチェーンの内側に入ることが条件となる。
国内データセンター事業者や、主権的および企業向けAI能力を構築するSIerエコシステムにとって、メッセージは、ネットワークアーキテクチャの決定が今や長期的な結果をもたらすということである。ベンダー固有の光モジュール経路へのコミットは短期的なパフォーマンスを最適化するが、将来のマルチベンダーの柔軟性を制約する。日本企業のAIファクトリー設計を助言するSIerは、インターコネクト戦略を調達の後付けではなく第一級のアーキテクチャ上の選択として扱い、GPUの選択と同じくらい真剣にビット当たり電力の経済性を評価すべきである。AIインフラプロジェクトが拡大するにつれ、モデルと計算の選択だけでなく、ファブリックのトレードオフを理解するチームが差別化を図るだろう。